2026年6月、サンフランシスコで開催された「Databricks Data + AI Summit 2026 (DAIS 2026)」に参加しました。
今回のDAISでは、「AIエージェントの本格活用に向けた基盤整備」が強く打ち出されていたと感じました。特に、AI活用におけるガバナンスや、企業固有のコンテキストをいかにAIに伝えるかということが大きなテーマとなっていました。
基調講演ではDatabricksの新機能やサービスについても、さまざまな発表がありましたが、それらについてはすでに多くの記事で詳しく紹介されています。そのため、本記事では基調講演の発表内容ではなく、現地で参加したセッションの一つである「Stop Guessing, Start Scoring: LLM Extraction Evaluation on Databricks」を取り上げます。
このセッションでは、LLMを利用して非構造化テキストから情報を抽出する処理を題材に、Ground Truthを用いた評価や、Human Feedbackの評価データへの活用、信頼度スコアを利用したレビューの効率化など、LLMによる抽出処理を継続的に評価・改善していくための考え方が紹介されていました。
本記事では、このセッションで紹介されていた考え方を参考に、DatabricksとMLflowを利用して、LLMによる構造化抽出の評価・改善サイクルを実際に構築してみます。
実際にDatabricksのFree Edition環境で動かせる実装例を、できるだけ省略せず交えながら、一連の流れに沿って紹介します。
※ 本記事はDAIS 2026のセッションで紹介された考え方を参考に、筆者が独自に構成・実装したものです。セッション内容の解説や再現を目的としたものではなく、記事の内容には筆者の解釈が含まれます。
※ 本記事に掲載しているコードは、実際に使用したコードを基に、可読性を考慮して一部を省略・変更した実装例です。すべての動作を保証するものではありません。実際に利用する際は、省略箇所の補完や、必要な処理の追加等が必要です。
想定読者
- DatabricksやMLflowを使い始めた方
- Databricksはよく使っているが、MLflowをあまり使ったことがない方
本記事で使用する主な技術・機能
- Databricks(執筆時点において、Free Editionで全て実行可能)
- MLflow
- Tracing
- Evaluation Datasets
- Custom Scorer / LLM Judge
- Prompt Registry(※1)
- Review Queues(※2)
※1 Databricks上では2026年10月10日時点でBeta版として提供されています
※2 Databricksでは、構造化情報の抽出に利用できるai_extract関数や、抽出ワークフローを支援するInformation Extraction機能が提供されています。本記事では、MLflowを用いた評価・改善プロセスを実践することに重点を置き、これらの抽出に特化した機能は利用せず、MLflowの各機能を直接組み合わせて実装します。
目次
1. セッションで紹介されたLLM評価の考え方
2. 今回実装する評価・改善サイクル
3. 評価用データセットとPrompt v1の準備
4. Baselineの実行と評価
5. 信頼度スコアを使ったHuman Review
6. Human Reviewを評価用データセットへ反映
7. 評価データ拡張後の再評価
8. Promptの改善
9. まとめ
1. セッションで紹介されたLLM評価の考え方
本章では、「Stop Guessing, Start Scoring: LLM Extraction Evaluation on Databricks」で紹介された考え方のうち、本記事の実装に関連する部分を簡単に紹介します。
セッションの動画はDatabricks公式サイトで公開されています。セッションそのものの詳細については、ぜひそちらを参照してください。
Stop Guessing, Start Scoring: LLM Extraction Evaluation on Databricks
1.1 構造化データ抽出を細かく評価する
LLMによる構造化データ抽出では、出力全体を一つのスコアで評価するだけでは、どこに問題があるのかを把握することが難しくなります。
セッションでは、構造化された出力をより細かい単位に分け、それぞれに適した方法で評価する考え方が紹介されていました。
例えば、値の一致をそのまま比較できる項目もあれば、表記揺れへの対応や意味的な比較が必要な項目もあります。
こうした評価を組み合わせることで、単に「正解・不正解」を判断するだけではなく、どこに改善の余地があるのかを分析できるようになります。
1.2 Human Feedbackを継続的な評価につなげる
もう一つ重要なのが、既存の業務におけるHuman Reviewを、継続的な評価につなげるという考え方です。
セッションで紹介された事例では、LLMによる抽出結果を業務の中で人がレビュー・修正し、その結果を収集して評価に活用していました。
ポイントは、評価データを作成するためだけにレビューを行うのではなく、既存の業務で行われるレビューを活用して、実運用の中から評価に利用できるデータを継続的に蓄積していくことです。
これにより、追加の人的コストを抑えながら、実際の業務で発生したデータを評価へ取り込み、LLMの精度を継続的に評価・監視できるようになります。
1.3 信頼度スコアを用いてレビューを効率化する
Human Reviewの際、すべての出力を同じように確認するのではなく、LLM Judgeによる信頼度スコア(Confidence score)を用いて、確認が必要な結果を見つけやすくする考え方も紹介されていました。
信頼度スコアが低い結果に対しては、より時間をかけてチェックを行うという運用が可能になります。
ここで重要なのは、信頼度スコアはレビュー工程を置き換えるものではなく、あくまでガイドとして利用するということです。
以下のようにサイクルを継続的に回しやすくするための考え方が、本セッションから得た重要なポイントの一つです。
データ抽出 → Human Review → フィードバックの収集 → 評価 → 改善
2. 今回実装する評価・改善サイクル
ここからは、前章で紹介した考え方を参考に、DatabricksとMLflowを利用してLLMの評価・改善サイクルを実際に構築していきます。
なお、ここから紹介するタスクや実装等は、元セッションを再現したものではなく、本記事用に独自に構成しています。
2.1 今回扱うタスク
今回は、企業について記述された文章から、IT製品・サービスの利用に関するイベントを構造化データとして抽出するタスクを題材とします。
例えば、文章中にクラウドサービスの導入や既存システムからの移行について記述されている場合、以下の情報を抽出します。
- product: 製品・サービス名
- action: 採用、利用、移行、利用終了
- status: 予定、進行中、完了
- purpose: 利用目的
また、文章中で対象となっている企業名を’company’として抽出します。
出力イメージは以下のようになります。
{ |
"company": "Example Company A", |
"events": [ |
{ |
"product": "Example Service", |
"action": "adopt", |
"status": "completed", |
"purpose": "データ分析基盤として利用" |
} |
] |
} |
一方、文章中に製品名が登場していても、単に比較・検討しただけで実際には採用されていない場合などは抽出対象としません。
単純なキーワード抽出ではなく、文章の内容を解釈した上で、複数のフィールドを構造化して出力するタスクとしています。
2.2 評価・改善の全体フロー
今回の実験では、最初からすべての評価データを用意するのではなく、Human Reviewを通じて評価用データセットを拡張していく流れを試します。
全体の流れは以下の通りです。
- Ground Truth付きの初期の評価用データセットを用意する
- Prompt v1を用いて推論し、Baselineを評価する
- 新しいデータに対してPrompt v1で推論する
- LLM Judgeを利用して信頼度スコアを算出する
- Review Queueで出力を確認し、正しい結果を付与する
- Human Reviewで得られたGround Truthを評価用データセットへ追加する
- 拡張した評価用データセットでPrompt v1を再評価する
- Promptを改善し、Prompt v2を再評価する
実運用では、この3~8を繰り返すことで継続的な評価・改善サイクルを実現できます。
2.3 利用するMLflowの機能
今回のフローでは、MLflowの以下の機能を利用します。
|
機能 |
概要 |
今回の用途 |
|---|
|
Tracing |
LLMアプリケーションの実行過程や入出力を記録 |
推論結果や評価結果をTraceとして記録 |
|
Evaluation Datasets |
LLMアプリケーションの評価に使用するデータセットを管理 |
入力データと正解データの蓄積 |
|
Custom Scorer / LLM Judge |
評価ロジックやLLMによる評価基準を定義 |
構造化抽出の精度評価、信頼度スコアの算出 |
|
Prompt Registry |
Promptを登録・バージョン管理 |
Prompt v1 / v2の管理 |
|
Review Queues |
人間によるレビューの管理 |
抽出結果の確認と正解データの収集 |
2.4 実験条件
今回の実験では、LLMモデルに’databricks-gpt-oss-120b’を使用します。
また、ライブラリのバージョンを以下のように指定しています。
%pip install "mlflow-skinny[databricks]==3.16.1" "databricks-agents==1.12.0" "databricks-sdk[openai]" |
dbutils.library.restartPython() |
データセットには、あらかじめLLMで生成した20件のサンプルデータを用意し、そのうち10件を初期評価用、残り10件を推論・レビュー用として使用します。
なお、本記事内でデータセットとして使用する文章は、実験用に用意したサンプルデータで、架空の企業や事例を使用しています。
また、本記事の内容は評価・改善サイクルの構築を主な目的としており、評価結果の厳密な分析や、モデル自体の性能評価を目的としたものではありません。
検証にはGround Truthを含めて、LLMで生成したサンプルデータを使用しています。
評価方法も簡易さを重視しているため、本記事で示す評価値はあくまで参考値としてご覧ください。
本記事に掲載しているコードは、実際に使用したコードを基に、可読性を考慮して一部を省略・変更した実装例です。
3. 評価用データセットとPrompt v1の準備
まず、Baselineの評価に使用するGround Truth付きの評価用データセットと、構造化抽出に使用するPromptを準備します。
3.1 評価用データセットの準備
評価用データセットには、企業におけるIT製品・サービスの利用状況について記述したサンプル文章を使用します。
各データには入力文章と、期待する抽出結果をGround Truthとして用意します。
入力文章は以下のような形式です。
(これはサンプルデータで、文章内の企業・事例は架空のものです。)
Example Logistics Aは、配送計画の高度化とデータ分析業務の効率化を目的に、社内の分析基盤を刷新した。従来は部門ごとにExcelや個別のデータベースを利用していたが、データの集約に時間がかかることが課題となっていた。複数のサービスを比較した結果、同社はDatabricksを新たなデータ分析基盤として採用し、2026年6月から本番利用を開始した。現在は配送実績や倉庫の稼働状況をDatabricks上で分析している。今後は需要予測への生成AI活用についても検討する方針だ。
この入力に対して、以下のように期待する抽出結果をGround Truthとして定義します。
{ |
"company": "Example Logistics A", |
"events": [ |
{ |
"product": "Databricks", |
"action": "adopt", |
"status": "completed", |
"purpose": "データ分析基盤" |
} |
] |
} |
以降では、このGround TruthとLLMによる抽出結果を比較して評価します。
入力文章によっては、イベントとして抽出すべきか難しいケースも考えられますが、今回はそのような曖昧さもあるものとして実装・評価を行います。
3.2 出力形式を定義する
LLMからは、企業名とIT製品・サービスに関するイベントを以下のフィールドで取得します。
|
フィールド |
内容 |
取りうる値 |
|---|
|
company |
対象となる企業名 |
自由な文字列 |
|
product |
製品・サービス名 |
自由な文字列 |
|
action |
採用・利用・移行・利用終了 |
adopt / use / migrate / discontinue |
|
status |
予定・進行中・完了 |
planned / in_progress / completed |
|
purpose |
利用目的 |
自由な文字列 / null |
実装ではPydanticを使用して、以下のように定義します。
from enum import Enum |
from pydantic import BaseModel |
class Action(str, Enum): |
ADOPT = "adopt" |
USE = "use" |
MIGRATE = "migrate" |
DISCONTINUE = "discontinue" |
class Status(str, Enum): |
PLANNED = "planned" |
IN_PROGRESS = "in_progress" |
COMPLETED = "completed" |
class ITEvent(BaseModel): |
product: str |
action: Action |
status: Status |
purpose: str | None |
class ExtractionResult(BaseModel): |
company: str |
events: list[ITEvent] |
また、後述するStructured Outputで出力形式を指定するため、JSON Schemaも定義します。
EXTRACTION_RESPONSE_SCHEMA = { |
"type": "object", |
"properties": { |
"company": { |
"type": "string", |
}, |
"events": { |
"type": "array", |
"items": { |
"type": "object", |
"properties": { |
"product": { |
"type": "string", |
}, |
"action": { |
"type": "string", |
"enum": [action.value for action in Action], |
}, |
"status": { |
"type": "string", |
"enum": [status.value for status in Status], |
}, |
"purpose": { |
"type": ["string", "null"], |
}, |
}, |
"required": ["product", "action", "status", "purpose"], |
"additionalProperties": False, |
}, |
}, |
}, |
"required": ["company", "events"], |
"additionalProperties": False, |
} |
3.3 評価用データセットの作成
用意した10件をMLflowのEvaluation Datasetsへ登録します。
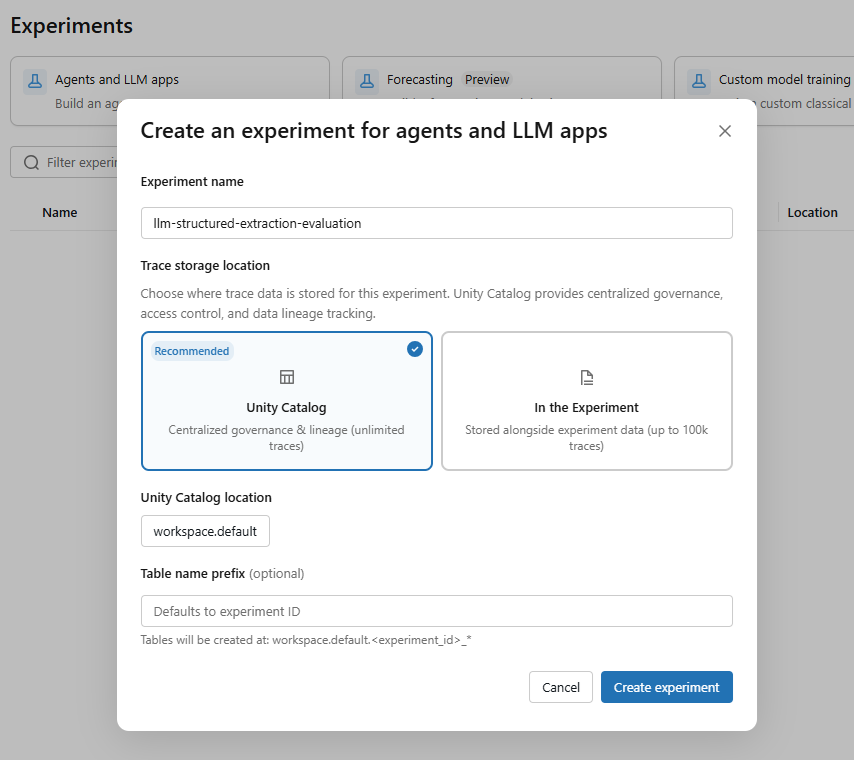
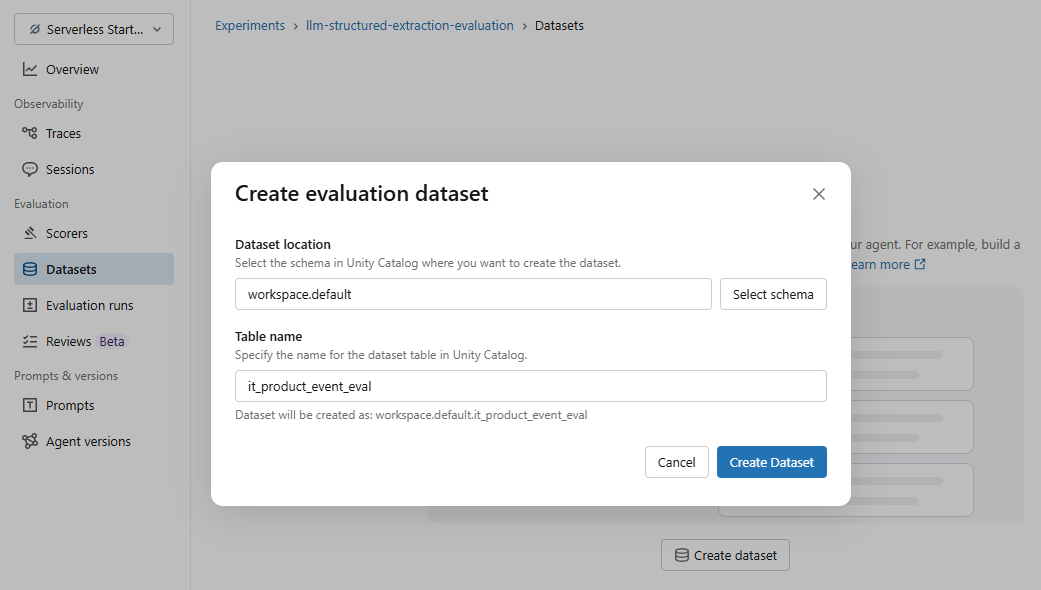
あらかじめ、Databricks上でMLflow ExperimentとEvaluation Datasetを作成しておきます。
Experiment名は「llm-structured-extraction-evaluation」とします。
Dataset table名は「it_product_event_eval」とします。
各レコードには、入力文章を ’inputs’ 、Ground Truthを ’expectations’ として登録します。
また、各データを識別できるように ’case_id’ をタグとして付与します。(’case_001’ ~ ‘case_010’)
例えば、元データから以下のようなレコードを作成します。
records = [] |
for i in range(1, 11): |
case_id = f"case_{i:03d}" |
case_dir = DATASET_ROOT / case_id |
input_text = (case_dir / "input.txt").read_text(encoding="utf-8") |
with open( |
case_dir / "ground_truth.json", |
encoding="utf-8" |
) as f: |
ground_truth = json.load(f) |
records.append( |
{ |
"inputs": { |
"text": input_text |
}, |
"expectations": { |
"expected_response": ground_truth |
}, |
"tags": { |
"case_id": case_id |
}, |
} |
) |
続いて、作成したEvaluation Datasetを取得し、 ’merge_records()’ で登録します。
import mlflow.genai.datasets |
DATASET_NAME = "workspace.default.it_product_event_eval" |
eval_dataset = mlflow.genai.datasets.get_dataset( |
name=DATASET_NAME |
) |
eval_dataset = eval_dataset.merge_records(records) |
結果はこちらです。(画像内のデータはサンプルデータで、文章内の企業・事例は架空のものです。)
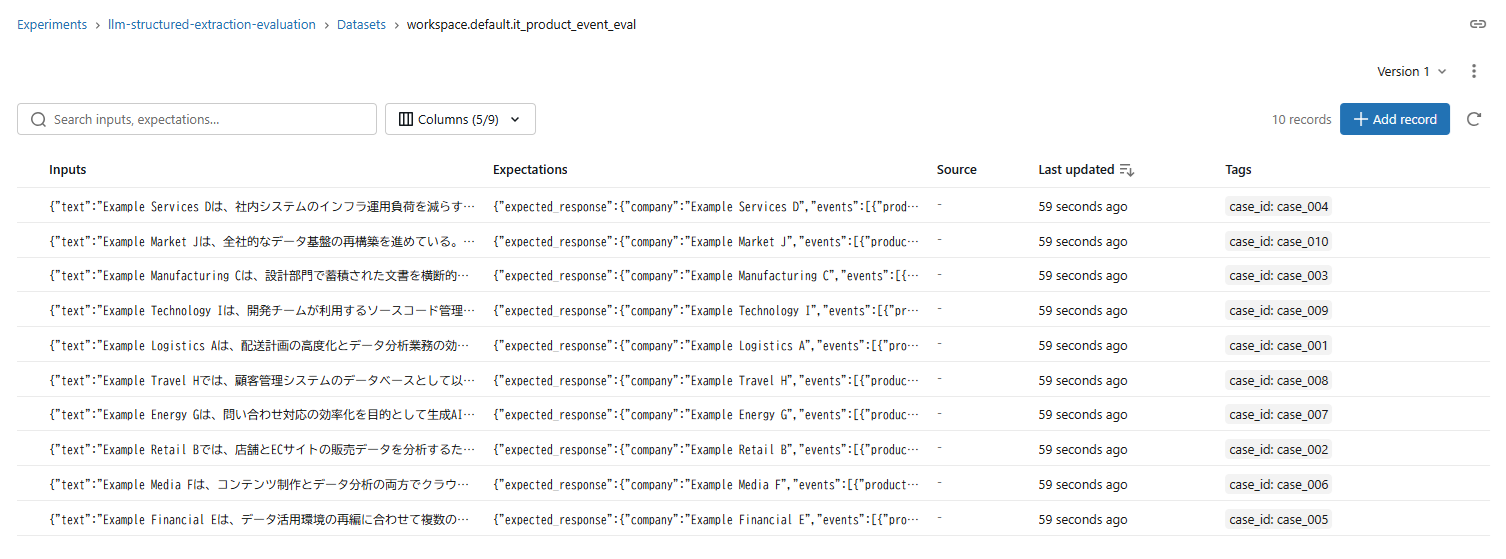
これで、入力データとGround TruthをMLflow上のEvaluation Datasetとして管理できるようになります。
後ほどHuman Reviewで新しいGround Truthを作成した際にも、同じEvaluation Datasetへレコードを追加します。
3.4 Prompt v1の作成・登録
続いて、Baselineとして使用するPrompt v1を作成します。
最初から個別ケースに対応する細かいルールを追加せず、抽出タスクに必要な基本的なルールのみ記載します。
作成したPromptはMLflow Prompt Registryへ登録します。
今回はPrompt本体だけでなく、前節で定義した出力Schemaも’response_format’として一緒に登録します。
from mlflow.genai import register_prompt |
USER_PROMPT = """ |
以下の文章から、IT製品・サービスに関するイベントを抽出してください。 |
文章: |
{{text}} |
""" |
prompt = register_prompt( |
name="workspace.default.it_product_event_extraction", |
template=[ |
{ |
"role": "system", |
"content": SYSTEM_PROMPT, |
}, |
{ |
"role": "user", |
"content": USER_PROMPT, |
}, |
], |
response_format=EXTRACTION_RESPONSE_SCHEMA, |
) |
UI上では、register_prompt()のnameで指定したスキーマを選択することで、登録したPromptを確認できるようになります。
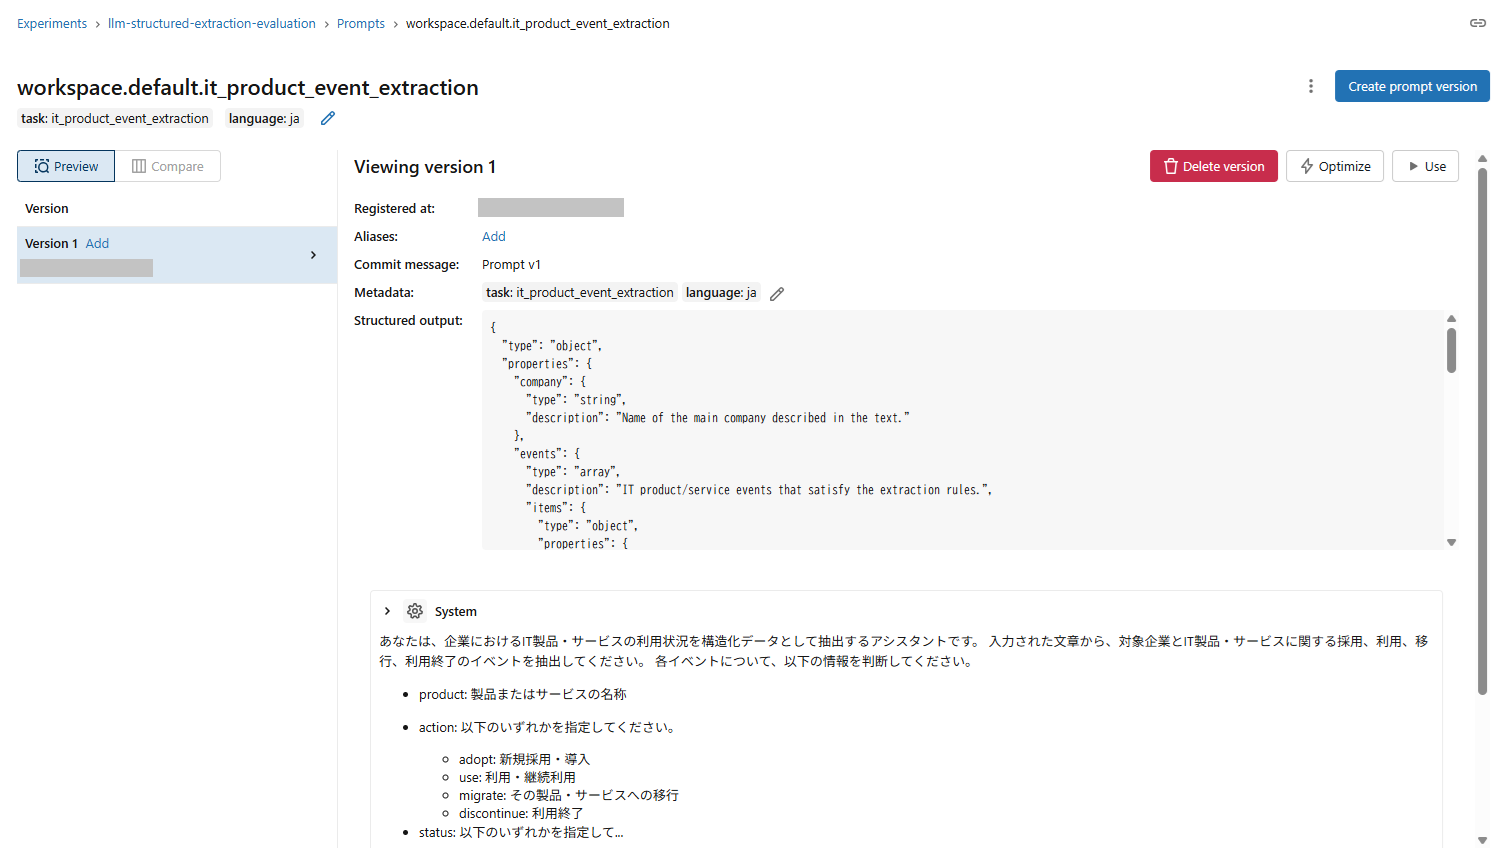
登録したPromptは、バージョンを指定して取得できます。
prompt = mlflow.genai.load_prompt( |
"prompts:/workspace.default.it_product_event_extraction/1" |
) |
後ほど、改善したPromptをバージョン2として登録します。
3.5 Structured Outputを用いて抽出
最後に、登録したPromptを用いて実際に構造化抽出を行う処理を用意します。
from databricks.sdk import WorkspaceClient |
workspace_client = WorkspaceClient() |
client = workspace_client.serving_endpoints.get_open_ai_client() |
def generate_structured( |
messages: list[dict[str, Any]], |
response_schema: dict[str, Any], |
) -> dict[str, Any]: |
|
response_format = { |
"type": "json_schema", |
"json_schema": { |
"name": "extraction_result", |
"schema": response_schema, |
"strict": True, |
} |
} |
response = client.chat.completions.create( |
model="databricks-gpt-oss-120b", |
messages=messages, |
response_format=response_format, |
temperature=0.0, |
) |
content = response.choices[0].message.content |
|
if not content: |
raise ValueError("LLM returned an empty response.") |
|
if isinstance(content, str): |
text = content |
elif isinstance(content, list): |
text_blocks = [ |
block["text"] for block in content |
if block.get("type") == "text" |
] |
|
if len(text_blocks) != 1: |
raise ValueError( |
f"Expected exactly one text block, got {len(text_blocks)}." |
) |
|
text = text_blocks[0] |
else: |
raise ValueError(f"Unexpected response format: {content}") |
|
try: |
return json.loads(text) |
except json.JSONDecodeError as e: |
raise ValueError( |
f"Failed to parse structured output as JSON: {content}" |
) from e |
@mlflow.trace |
def extract(text: str) -> ExtractionResult: |
raw = generate_structured( |
messages= prompt.format(text=text), |
response_schema=prompt.response_format, |
) |
try: |
return ExtractionResult.model_validate(raw) |
except ValidationError as exc: |
raise ValueError( |
f"LLM output does not match the extraction schema.\nRaw output: {raw}" |
) from exc |
ここではStructured Outputを利用(response_formatを指定)することで、LLMの回答を定義したSchemaに沿ったJSONとして取得します。
これでBaseline評価に必要な準備と、構造化抽出を実行する処理が整いました。
次章では、Prompt v1を用いて初期評価用データセットに対する推論を実行し、MLflow Tracingに記録した結果をCustom Scorerで評価します。
4. Baselineの実行と評価
前章で準備したEvaluation DatasetとPrompt v1を用いて、Baselineの推論と評価を行います。
今回は、LLMの出力全体を単純に比較するのではなく、抽出したイベントを対応付けた上で、イベント単位・フィールド単位の2つの観点から評価します。
4.1 Evaluation Datasetを取得して推論
まず、前章で作成したEvaluation Datasetを取得します。
from dataclasses import dataclass |
@dataclass |
class InputCase: |
case_id: str |
text: str |
@dataclass |
class DatasetCase(InputCase): |
ground_truth: dict |
def load_cases( |
dataset_name: str, |
) -> list[DatasetCase]: |
dataset = mlflow.genai.datasets.get_dataset( |
name=dataset_name, |
) |
df = dataset.to_df() |
cases = [] |
for _, row in df.iterrows(): |
cases.append( |
DatasetCase( |
case_id=row["tags"]["case_id"], |
text=row["inputs"]["text"], |
ground_truth=row["expectations"]["expected_response"], |
) |
) |
return cases |
Evaluation Datasetには ’inputs’ と ’expectations’ が含まれるため、 ’inputs’ の文章をLLMへ渡し、 ’expectations’ のGround Truthを後ほど評価に利用します。
取得したデータに対して、前章で実装した抽出処理を実行します。
@mlflow.trace |
def run_case( |
case: InputCase, |
run_type: str, |
) -> dict[str, Any]: |
mlflow.update_current_trace( |
tags={ |
"case_id": case.case_id, |
"run_type": run_type, |
} |
) |
try: |
result = extract(case.text) |
return { |
"case_id": case.case_id, |
"success": True, |
"prediction": result.model_dump(), |
"error": None, |
} |
except Exception as exc: |
return { |
"case_id": case.case_id, |
"success": False, |
"prediction": None, |
"error": str(exc), |
} |
def run_cases( |
cases: list[InputCase], |
run_type: str, |
) -> list[dict[str, Any]]: |
results = [] |
for case in cases: |
print(f"Running: {case.case_id}") |
result = run_case( |
case=case, |
run_type=run_type, |
) |
results.append(result) |
return results |
抽出処理に「@mlflow.trace」を付けることで、入出力や実行情報をTraceとして記録できます。
以下のようにして、実際に推論を実行します。
EXPERIMENT_NAME = f"/Users/{_USER}/llm-structured-extraction-evaluation" |
mlflow.set_experiment(EXPERIMENT_NAME) |
DATASET_NAME = "workspace.default.it_product_event_eval" |
cases = load_cases(DATASET_NAME) |
RUN_TYPE = "baseline_v1" |
baseline_results = run_cases( |
cases=cases, |
run_type=RUN_TYPE, |
) |
実行が完了すると、UIからは次のようにTraceを確認できます。
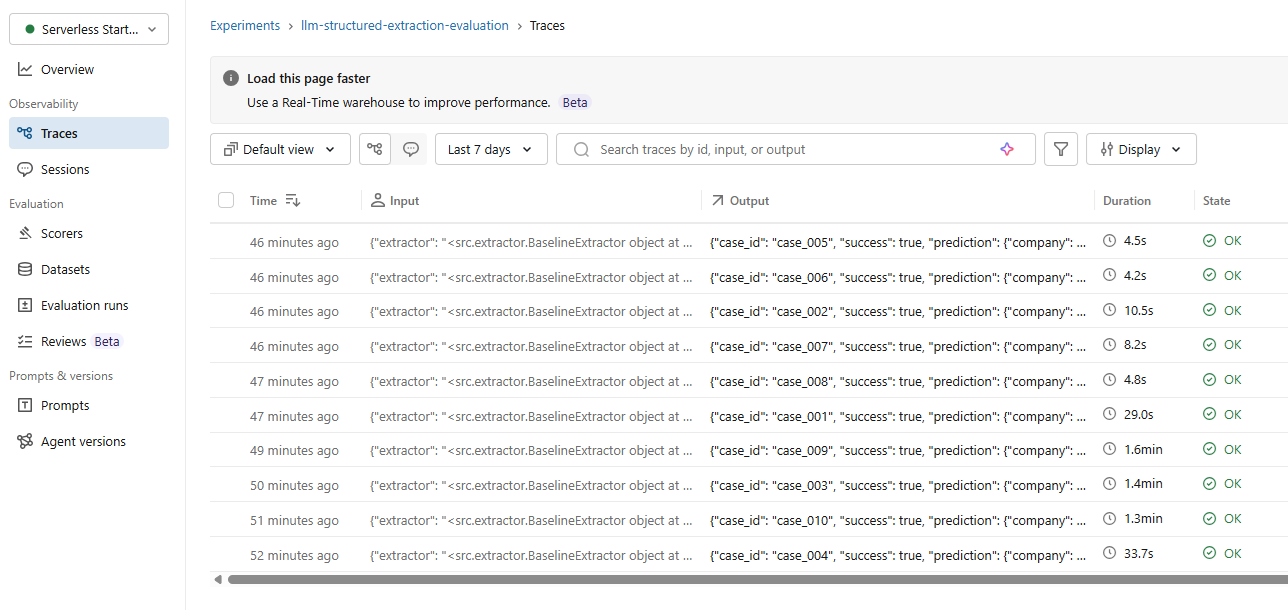
後ほど新しいデータに信頼度スコアを付与したり、Human Reviewを行ったりする際にもTraceを利用します。
4.2 イベントを対応付けて評価
今回の出力には複数のイベントが含まれるため、JSON全体の一致だけでは評価しません。
例えば、Ground Truthが次のような2つのイベントを持っているとします。
"events": [ |
{ |
"product": "product A", |
"action": "discontinue", |
"status": "completed", |
"purpose": "..." |
}, |
{ |
"product": "product B", |
"action": "migrate", |
"status": "completed", |
"purpose": "..." |
} |
] |
LLMの出力ではイベントの順序が変わる可能性があるため、配列の1件目同士、2件目同士をそのまま比較することはできません。
そこで今回は簡単なマッチングとして、’product’と’action’をキーにして、予測結果とGround Truthのイベントを対応付けます。(あくまで簡易実装であり、実際にはデータの特性を踏まえて検討すべきです。)
def event_key(event: dict) -> tuple[str, str]: |
return ( |
normalize_product(event["product"]), |
event["action"], |
) |
’product’については、大文字・小文字や前後の空白など、評価上無視したい差異を簡単に正規化します。
def normalize_product(value: str) -> str: |
return value.strip().lower() |
対応するイベントが見つかった場合は、そのイベントについて各フィールドを評価します。
一方、Ground Truthに存在するイベントが予測されていない場合や、Ground Truthに存在しないイベントが余分に抽出された場合は、後述するようなイベント単位の評価に反映します。
4.3 フィールドごとに評価方法を変える
対応付けたイベントについて、各フィールドを以下の方法で評価します。
|
フィールド |
評価方法 |
|---|
|
product |
正規化後の文字列を比較 |
|
action |
完全一致 |
|
status |
完全一致 |
|
purpose |
LLM Judgeによる意味的な比較 |
‘product’、’action’、’status’は、今回のデータでは比較的明確な値として定義できるため、文字列による比較を行います。
一方、’purpose’は同じ内容でも異なる表現になる可能性があります。
例えば、以下の場合、文字列としては一致しませんが、意味的には同じ目的を表している可能性があります。
そこで、’purpose’についてはLLM Judgeを利用して意味的な一致を判定します。
JudgeにはPredictionとGround Truthを渡し、両者が同じ利用目的を表しているかを判定させます。
from mlflow.genai.judges import make_judge |
purpose_semantic_judge = make_judge( |
name="purpose_semantic_match", |
instructions=""" |
{{ outputs }} はLLMが抽出したIT製品・サービスの利用目的です。 |
{{ expectations }} はGround Truthの利用目的です。 |
2つの利用目的が意味的に同じ内容を表しているか判定してください。 |
表現や言い回し、詳細度が多少異なっていても、 |
本質的な利用目的が同じであれば "match" としてください。 |
利用目的の意味が異なる場合は "mismatch" としてください。 |
""".strip(), |
feedback_value_type=Literal["match", "mismatch"], |
model="databricks:/databricks-gpt-oss-120b", |
) |
def purpose_match( |
prediction: str | None, |
expected: str | None, |
) -> bool: |
if prediction is None and expected is None: |
return True |
if prediction is None or expected is None: |
return False |
feedback = purpose_semantic_judge( |
outputs=prediction, |
expectations={"expected_purpose": expected}, |
) |
return feedback.value == "match" |
このように、形式的に比較できるフィールドと、意味的な評価が必要なフィールドで評価方法を分けます。
4.4 Custom Scorerの実装
ここまでの評価処理をMLflowのCustom Scorerとして実装します。
今回のScorerでは、まず予測結果とGround Truthのイベントを’product + action’で対応付けます。
対応するイベントが見つかった場合は各フィールドを評価し、すべて正しければTP(True Positive)とします。
一方、一つでも誤りがある場合は、そのイベントを正しく抽出できていないものとしてFP(False Positive)とFN(False Negative)の両方にカウントします。
また、
- Ground Truthに存在するがPredictionに存在しないイベント → FN
- Predictionにだけ存在する余分なイベント → FP
として扱います。
実装の主要部分は以下のようになります。
(コード量が大きいため、処理の流れが分かる部分のみ掲載し、主要部分以外は省略します)
from mlflow.entities import Feedback |
from mlflow.genai.scorers import scorer |
def evaluate_event( |
prediction: dict, |
expected: dict, |
) -> EventEvaluation: |
scores = FieldScores( |
~省略(product, action, statusの評価処理)~ |
purpose=purpose_match( |
prediction["purpose"], |
expected["purpose"], |
), |
) |
return EventEvaluation( |
event_key=event_key(expected), |
prediction=prediction, |
expected=expected, |
field_scores=scores, |
) |
def evaluate_case( |
case_id: str, |
prediction: dict, |
ground_truth: dict, |
) -> CaseEvaluation: |
company_correct = exact_match( |
prediction["company"], |
ground_truth["company"], |
) |
~省略~ |
predictions_by_key = {} |
for event in predicted_events: |
key = event_key(event) |
predictions_by_key.setdefault(key, []).append(event) |
for expected in expected_events: |
key = event_key(expected) |
candidates = predictions_by_key.pop(key, []) |
if not candidates: |
false_negatives += 1 |
continue |
# シンプルなマッチングルール: |
# 1つ目の予測をマッチさせる、それ以外はFP |
matched_prediction = candidates[0] |
evaluation = evaluate_event( |
prediction=matched_prediction, |
expected=expected, |
) |
matched_events.append(evaluation) |
false_positives += len(candidates) - 1 |
# 予測に含まれるが、期待値に含まれないEventはFP |
for remaining in predictions_by_key.values(): |
false_positives += len(remaining) |
return CaseEvaluation( |
case_id=case_id, |
company_correct=company_correct, |
matched_events=matched_events, |
false_positives=false_positives, |
false_negatives=false_negatives, |
) |
def summarize_case( |
evaluation: CaseEvaluation, |
) -> dict[str, int]: |
tp = 0 |
fp = evaluation.false_positives |
fn = evaluation.false_negatives |
~省略(正解数を0で初期化)~ |
for event in evaluation.matched_events: |
product_correct += int(event.field_scores.product) |
action_correct += int(event.field_scores.action) |
status_correct += int(event.field_scores.status) |
purpose_correct += int(event.field_scores.purpose) |
if event.correct: |
tp += 1 |
else: |
# 対応するEventは存在したが、完全には正しくなかったケース |
fp += 1 |
fn += 1 |
return { |
"company_correct": int(evaluation.company_correct), |
"event_tp": tp, |
"event_fp": fp, |
~省略(マッチしたイベント数や各フィールドの正解数を同様に返す)~ |
} |
@scorer(name="structured_extraction") |
def structured_extraction_scorer( |
outputs: dict, |
expectations: dict, |
) -> list[Feedback]: |
~省略~ |
evaluation = evaluate_case( |
case_id=case_id, |
prediction=prediction, |
ground_truth=expectations[ |
"expected_response" |
], |
) |
summary = summarize_case(evaluation) |
return [ |
Feedback( |
name="company_correct", |
value=summary["company_correct"], |
), |
Feedback( |
name="event_tp", |
value=summary["event_tp"], |
), |
Feedback( |
name="event_fp", |
value=summary["event_fp"], |
), |
~省略(マッチしたイベント数や各フィールドの正解数を同様に返す)~ |
] |
今回の対応付けでは単純化のため、同じ’product + action’を持つイベントが複数存在する場合、最初に一致した未使用のPredictionを対応付けます。
関数に@scorerを付与することで、その関数をMLflowのCustom Scorerとして定義します。
Scorerには、評価対象となるLLMの出力が’outputs[“prediction”]’として、Evaluation Datasetに設定した期待値が’expectations’として渡される想定で実装します。
‘structured_extraction_scorer()’ではそれらを用いて、イベント単位のTP / FP / FNや各フィールドの正解数を算出しています。
算出の際には、4.3 で作成した’purpose_match()’も呼び出しています。
算出した値はFeedbackとして返します。
これにより、’mlflow.genai.evaluate()’を実行した際に、各Traceに評価結果としてMLflowに記録されます。
ここまでは、あくまでケースごと(データセットの1件ごと)に行う評価処理となります。
4.5 評価対象のTraceを取得
ここまでで、各ケースの評価方法を定義できました。
ここからは、実際に評価を行うために、初期10件のTraceから推論結果を取得します。
まず、Traceの取得にはDatabricks SQL Warehouseが必要です。
SQL Warehouseの概要ページでIDを確認し、次のように設定します。
os.environ["MLFLOW_TRACING_SQL_WAREHOUSE_ID"] = "<SQL_WAREHOUSE_ID>" |
次に、’mlflow.search_traces()’を使用して、初期10件のTraceを取得します。
experiment = mlflow.set_experiment(EXPERIMENT_NAME) |
traces = mlflow.search_traces( |
locations=[experiment.experiment_id], |
filter_string=( |
f"tag.run_type = '{run_type}'" |
), |
return_type="pandas", |
) |
ここでは、推論時にタグ付けした’run_type’を使用して、Baselineとして実行したTraceだけを検索しています。
4.6 TraceにGround Truthを付与して評価
取得したTraceには推論時の入力と出力が記録されています。
一方、Custom Scorerで評価するためには、対応するGround Truthも必要です。
そこで、Traceの’case_id’を用いてEvaluation Datasetのデータと対応付け、’expectations’として追加します。
cases_by_id = { |
case.case_id: case for case in cases |
} |
traces["expectations"] = traces.apply( |
lambda row: { |
"expected_response": |
cases_by_id[ |
row["tags"]["case_id"] |
].ground_truth |
}, |
axis=1, |
) |
これで、評価するための準備が整いました。
それでは実際に、先ほど実装したCustom Scorerを使用して評価を行います。
with mlflow.start_run( |
run_name="baseline_v1_evaluation" |
): |
evaluation_result = mlflow.genai.evaluate( |
data=traces, |
scorers=[structured_extraction_scorer], |
) |
result_df = evaluation_result.result_df |
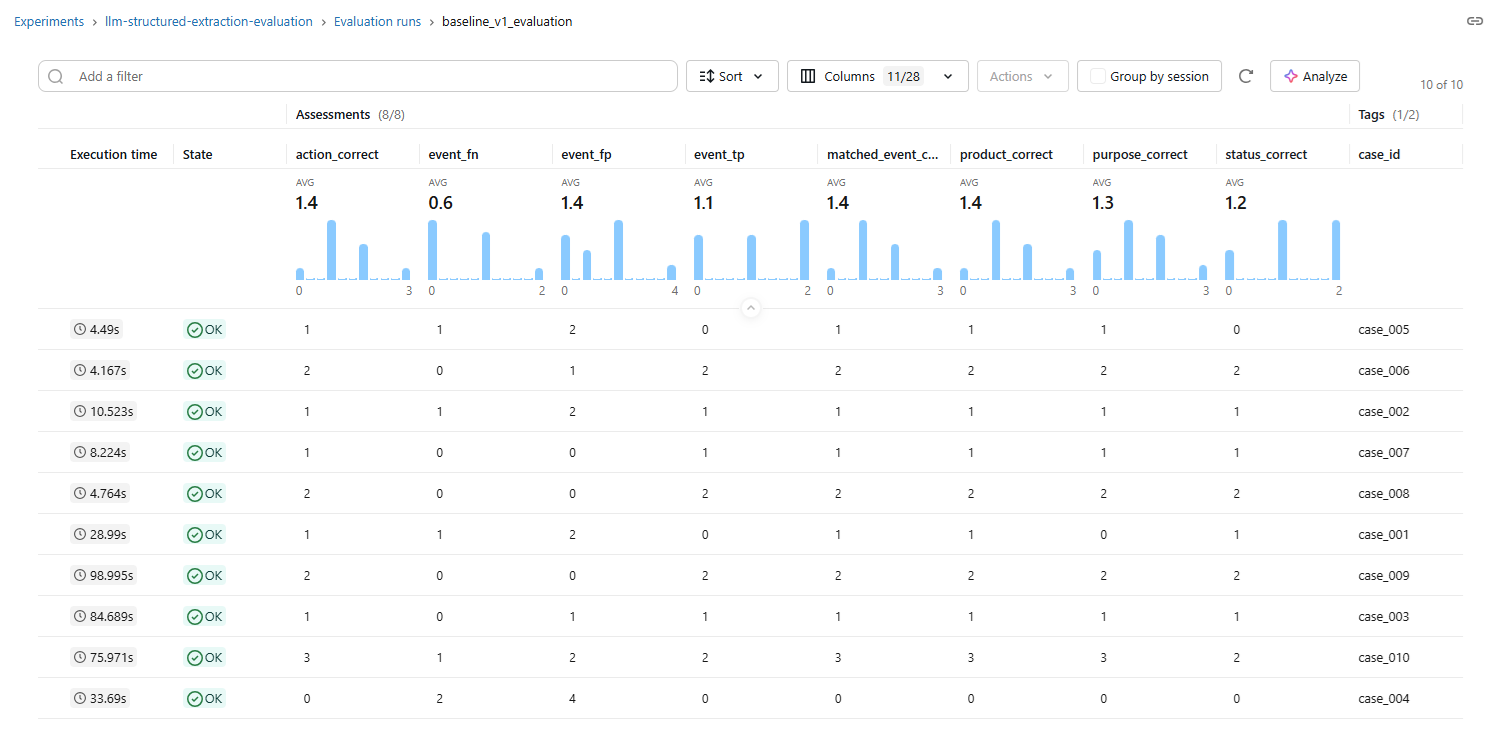
実行後、「Evaluation runs」を開くと、実行したRunが表示されます。
Runの詳細ページでは、このように評価結果を確認できます。
4.7 データセット全体の指標を集計
Custom Scorerでは、各TraceについてTP / FP / FNや、フィールドごとの正解数などを記録しました。
一方で、評価データセット全体におけるパフォーマンスを知るためには、各Traceの結果を集計する必要があります。
そのため、各ケースで得られたTP / FP / FNや正解数を集計して、Precision / Recall / F1 / 各フィールドのAccuracyを算出します。
(コード量が大きいため、処理の流れが分かる部分のみ掲載し、主要部分以外は省略します)
def aggregate_summaries( |
summaries: list[dict[str, int]], |
) -> dict[str, float | int]: |
total_company_correct = sum(s["company_correct"] for s in summaries) |
total_tp = sum(s["event_tp"] for s in summaries) |
total_fp = sum(s["event_fp"] for s in summaries) |
total_fn = sum(s["event_fn"] for s in summaries) |
~省略(マッチしたイベント数や各フィールドの正解数に対し同様の処理を行う)~ |
precision = ( |
total_tp / (total_tp + total_fp) |
if total_tp + total_fp |
else 0.0 |
) |
recall = ( |
total_tp / (total_tp + total_fn) |
if total_tp + total_fn |
else 0.0 |
) |
f1 = ( |
2 * precision * recall / (precision + recall) |
if precision + recall |
else 0.0 |
) |
def field_accuracy( |
correct: int, |
) -> float: |
return ( |
correct / total_matched |
if total_matched |
else 0.0 |
) |
return (集計結果等を返す) |
metrics = aggregate_summaries(summaries) |
‘aggregate_summaries ‘の引数に渡されている‘summaries’は、評価結果の’result_df’から集計に必要な値を取り出したものです。(本記事ではsummariesの作成部分は省略します)
この集計結果も、先ほどの評価結果(Evaluation run)に紐づくように記録します。
metrics = aggregate_summaries(summaries) |
mlflow.log_metrics( |
{ |
"company_accuracy": metrics["company_accuracy"], |
"event_tp": metrics["event_tp"], |
"event_fp": metrics["event_fp"], |
"event_fn": metrics["event_fn"], |
"event_precision": metrics["event_precision"], |
"event_recall": metrics["event_recall"], |
"event_f1": metrics["event_f1"], |
"product_accuracy": metrics["product_accuracy"], |
"action_accuracy": metrics["action_accuracy"], |
"status_accuracy": metrics["status_accuracy"], |
"purpose_accuracy": metrics["purpose_accuracy"], |
}, |
run_id=evaluation_result.run_id, |
) |
‘run_id’に先ほどのEvaluation Runと同じIDを指定することで、集計結果を同じRun上で確認できるようになります。
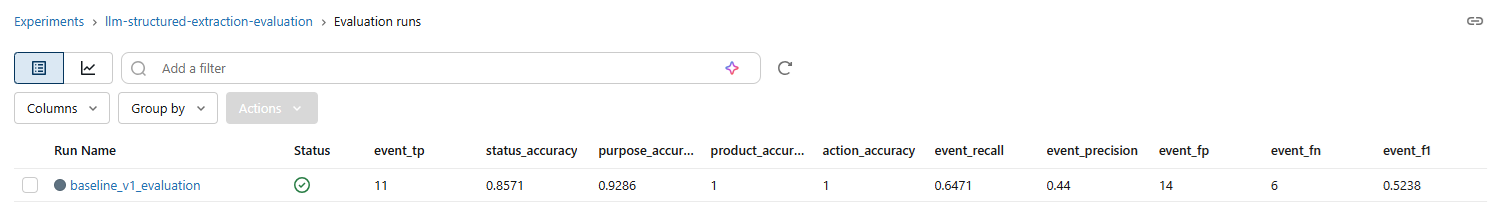
4.8 Baselineの評価結果
初期10件に対するPrompt v1の評価結果は、以下のようになりました。
|
指標 |
Baseline |
|---|
|
Company Accuracy |
1.000 |
|
TP |
11 |
|
FP |
14 |
|
FN |
6 |
|
Precision |
0.440 |
|
Recall |
0.647 |
|
F1 |
0.524 |
|
Matched Events |
14 |
|
Status Accuracy |
0.857 |
|
Purpose Accuracy |
0.929 |
'product_accuracy'と'action_accuracy'も一応計測していますが、’product’と’action’をキーにしてマッチングさせていることから、当然スコアは1.0になるため省略しています。
’product’と’action’の間違いは、FP, FNに吸収されています。
また、'status_accuracy'と'purpose_accuracy'はPredictionとGround Truthを対応付けることができたイベントのみを対象とした値である点に注意が必要です。
BaselineではRecallがPrecisionより高く、必要なイベントをある程度抽出できている一方で、余分なイベントを抽出する傾向があることが分かります。
また、対応付けられたイベントの中でも、’status’や’purpose’では一部に誤りが見られました。
これで、今後の比較基準となるBaselineを取得できました。
次章では、Ground Truthを持たない新しいデータに対して推論を行い、信頼度スコアを用いてHuman Reviewを実施します。
5. 信頼度スコアを使ったHuman Review
ここまでの評価では、Ground Truthを持つ10件のデータを用いて精度を確認しました。
ここからは、実運用を想定したGround Truthを持たないデータに対して推論を行い、LLM Judgeによる信頼度スコアを付与します。
5.1 Ground Truthのないデータで推論
まず、追加用データセットとして’case_011’ ~ ’case_020’の10件を用意します。
(実験用データにはGround Truthを用意していますが、この章ではGround Truthを参照せず、未付与のデータとして扱います。)
まずは追加用データセットを読み込みます。
additional_cases = [] |
for i in range(11, 21): |
case_id = f"case_{i:03d}" |
case_dir = ADDITIONAL_CASES_PATH / case_id |
input_text = (case_dir / "input.txt").read_text( |
encoding="utf-8" |
) |
additional_cases.append( |
InputCase( |
case_id=case_id, |
text=input_text, |
) |
) |
続いて、4.1節と同じように、Prompt v1を用いて推論します。
RUN_TYPE = "additional_v1" |
additional_results = run_cases( |
cases=additional_cases, |
run_type=RUN_TYPE, |
) |
実行後、Traceにも同様に表示されます。
5.2 信頼度スコアを算出
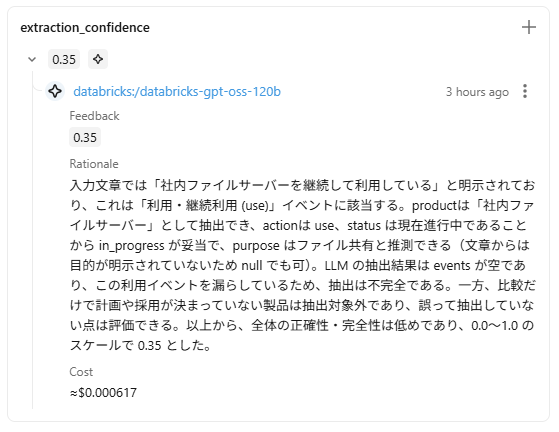
Human Reviewを実施する際のガイドとなる、信頼度スコアをLLM Judgeで算出します。
実装方法は’purpose_semantic_judge’のときとほとんど同じです。
入力文章と推論結果を比較し、0.0~1.0の値で、抽出結果の正しさの確信度を出力させます。
confidence_judge = make_judge( |
name="extraction_confidence", |
instructions=""" |
{{ inputs }} は、IT製品・サービスのイベント抽出対象となった入力文章です。 |
{{ outputs }} は、その文章からLLMが抽出した構造化結果です。 |
入力文章と抽出結果を比較し、 |
以下の抽出ルールに基づいて、 |
抽出結果全体が正確かつ完全である確信度を0.0~1.0で評価してください。 |
【抽出ルール】 |
抽出対象となるイベントは、企業におけるIT製品・サービスの |
採用、利用、移行、利用終了です。 |
各イベントには以下の情報が含まれます。 |
~Prompt v1とほぼ同じのため省略~ |
以下の場合は抽出対象に含めません。 |
- 検討、評価、比較、候補として言及されただけの製品 |
- 導入や移行の計画が取り下げられ、実際には採用・利用・移行されなかった製品 |
- 入力文章から確認できない、推測によるイベント |
【評価観点】 |
以下を総合的に評価してください。 |
- 抽出対象となるイベントを漏れなく抽出できているか |
- 抽出対象ではないイベントを抽出していないか |
- productが適切か |
- actionが適切か |
- statusが適切か |
- purposeが入力文章の内容と整合しているか |
0.0は、 |
「抽出結果全体が正しい可能性が非常に低い」 |
ことを意味します。 |
1.0は、 |
「抽出結果全体が正しいと強く確信できる」 |
ことを意味します。 |
Ground Truthは与えられていません。 |
入力文章、抽出結果、および上記の抽出ルールだけに基づいて |
Confidenceを評価してください。 |
評価理由(rationale)は日本語で記述してください。 |
""".strip(), |
feedback_value_type=float, |
model="databricks:/databricks-gpt-oss-120b", |
) |
次に、追加10件のTraceを取得し、それぞれについてConfidence Judgeを実行します。
Traceに保存されている入力文章と推論結果を取り出し、Judgeへ渡します。
(Traceの取得は4.5とほとんど同じのため割愛します)
confidence_results = [] |
for _, trace in traces.iterrows(): |
trace_id = trace["trace_id"] |
case_id = trace["tags"]["case_id"] |
request =json.loads(trace["request"]) |
response = json.loads(trace["response"]) |
judge_inputs = { |
"text": request["case"]["text"], |
} |
judge_outputs = response["prediction"] |
print(f"Scoring: {case_id}") |
feedback = confidence_judge( |
inputs=judge_inputs, |
outputs=judge_outputs, |
) |
confidence = feedback.value |
mlflow.log_assessment( |
trace_id=trace_id, |
assessment=feedback, |
) |
confidence_results.append( |
{ |
"case_id": case_id, |
"trace_id": trace_id, |
"confidence": confidence, |
"rationale": feedback.rationale, |
} |
) |
LLM Judgeから得られたFeedbackは、’mlflow.log_assessment()’を使用して元のTraceに記録します。
また、信頼度スコアだけでなく、LLM Judgeの判断根拠(rationale)も出力されるため、なぜそのスコアになったのかもTraceから確認できます。
5.3 Review Queueの作成・実施
推論した結果を確認し、MLflowのReview Queueを利用して手動レビューします。
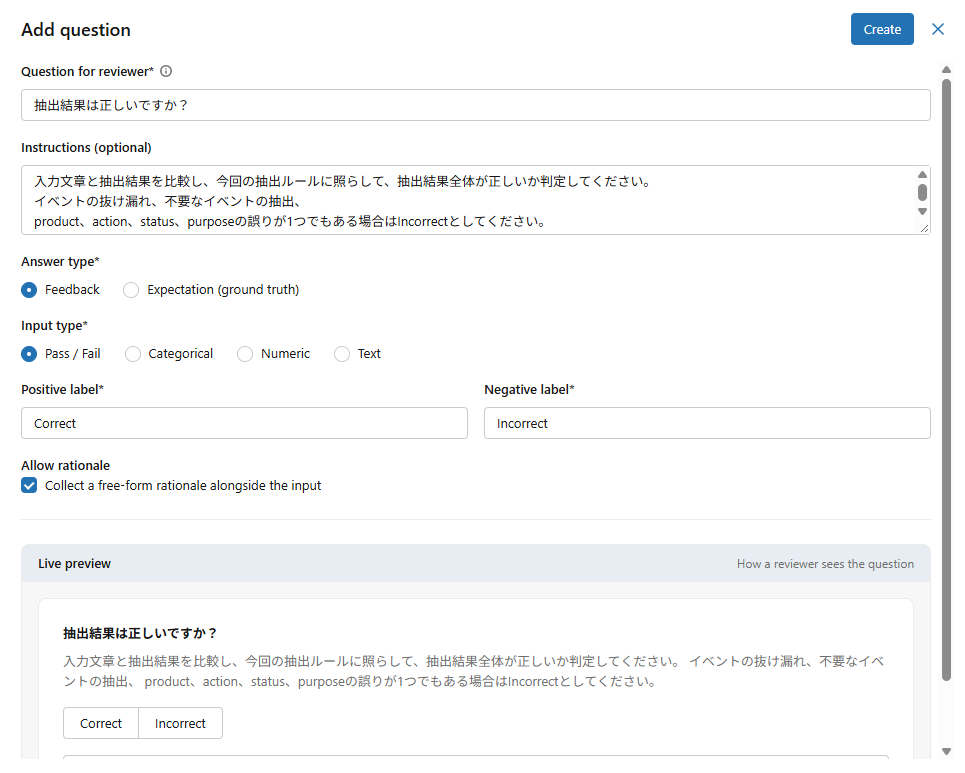
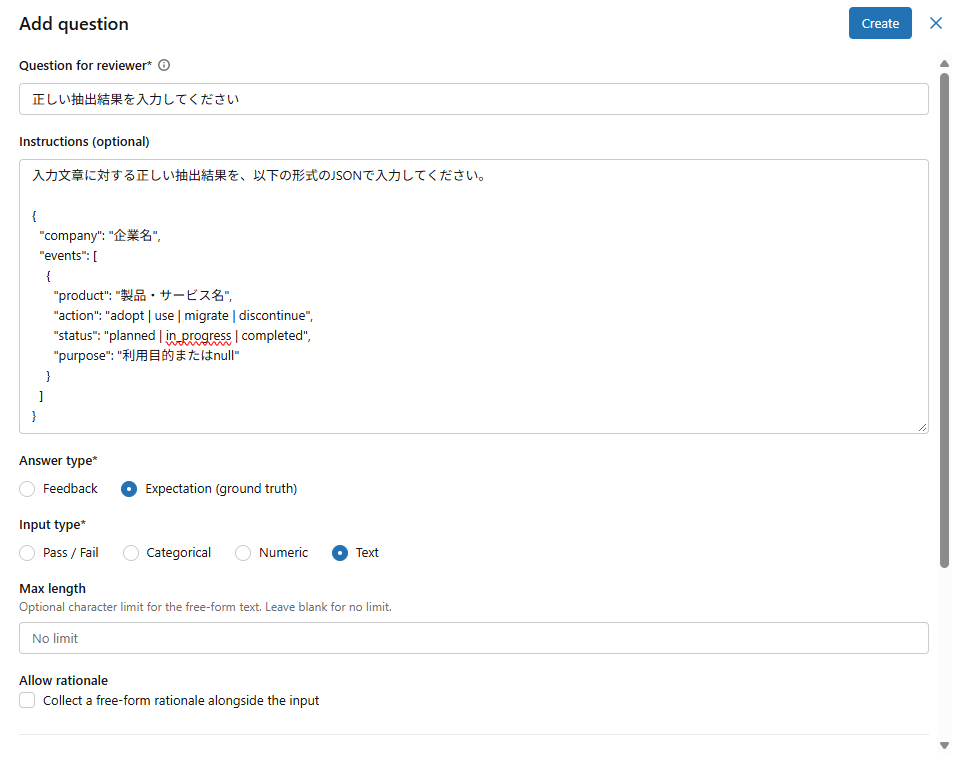
Review Queueでレビューを行うには、あらかじめ質問を用意しておく必要があります。
DatabricksのUIからMLflow Experiment内のReview Queueを開き、「Manage Questions」から質問を作成します。
Review Queueには、次の2つの質問を設定します。
|
質問 |
種類 |
内容 |
|---|
|
抽出結果は正しいですか? |
Feedback |
Correct / Incorrect |
|
正しい抽出結果を入力してください。 |
Expectation |
正しい抽出結果をJSONで入力 |
Review Queueでは、レビュー結果をFeedbackとExpectationとして記録できます。
- Feedback: 現在のLLM出力に対する評価を記録。
- Expectation: その入力に対して期待される正しい出力を記録。
1つ目の質問では、入力文章と抽出結果を比較し、イベントの抜け漏れや余分な抽出、各フィールドのいずれかに誤りがあれば’Incorrect’とします。
2つ目の質問では、正しい抽出結果をJSON形式で入力してもらい、その回答をExpectation(Ground Truth)として記録します。
- 1つ目の質問
- 2つ目の質問
質問を作成したら、次はReview Queueを作成します。
Review Queueの名前と、レビュアー、それから作成した質問を選択するだけです。
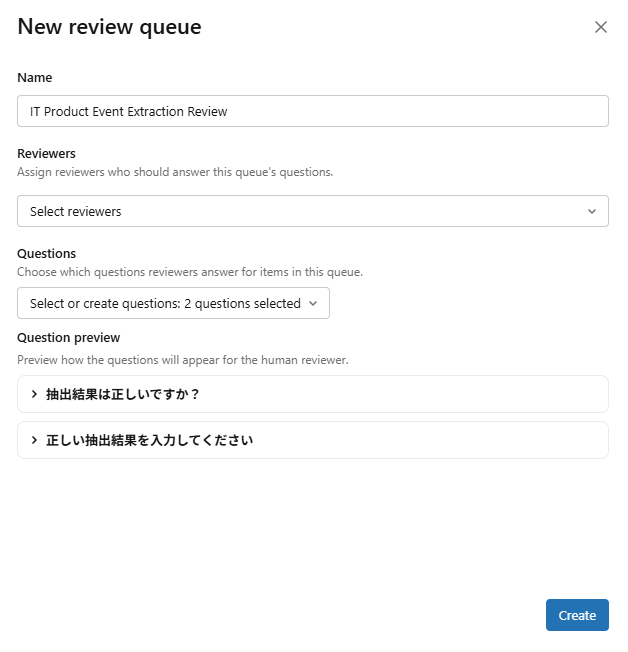
作成できたら、次はTraceをReview Queueに取り込みます。
Review Queueの画面で、「Add traces」ボタンを押下します。
Traceを選択する画面になりましたが、ここで信頼度スコアを活用します。
Filtersボタンを押下し、以下のように設定します。(閾値の0.9はデモ用に仮で決めた値です。)
|
Field |
Name |
Operator |
Value |
|---|
|
Assessments |
extraction_confidence |
< |
0.9 |
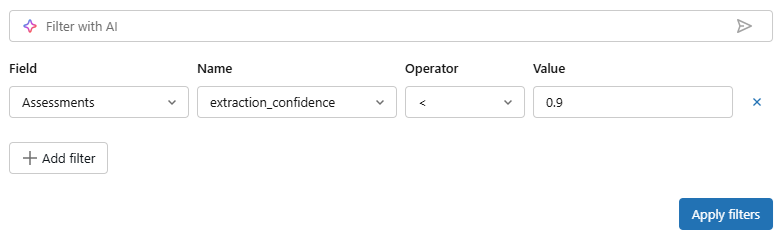
すると、信頼度スコアが0.9未満の4件がヒットしました。
今回は、この4件をレビューして、Ground Truthを作成します。
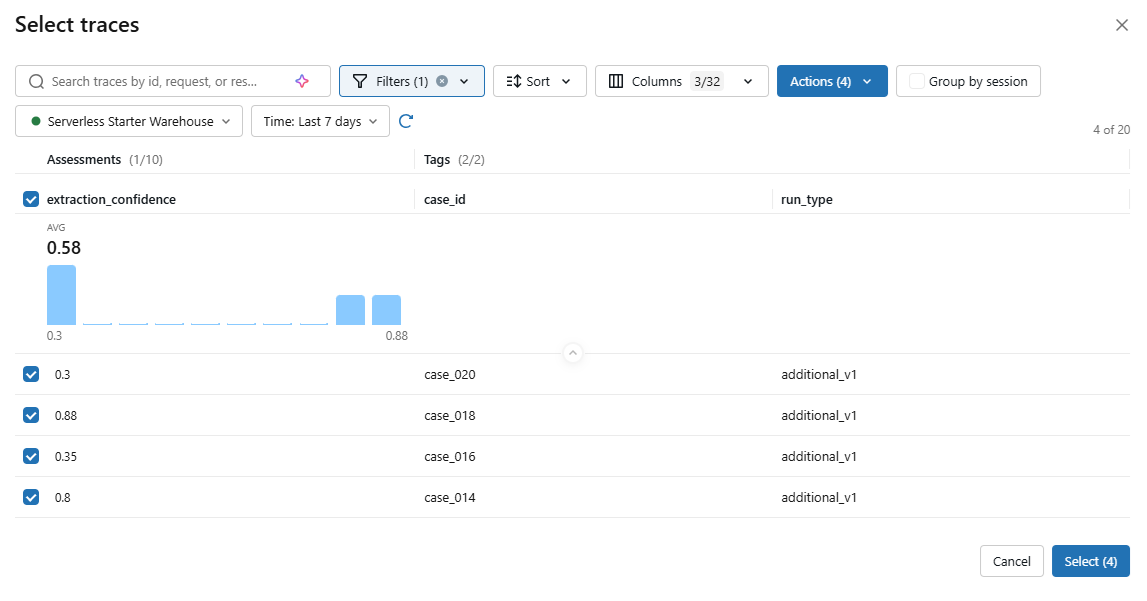
ここで、信頼度によるフィルタリングは、問題のありそうなケースを早く見つけるために行っています。
信頼度スコアはあくまでガイドであり、正解・不正解を決めるものではない、ということには注意が必要です。
Review Queueの詳細画面で、先ほど選択したTraceが入っていることを確認し、レビューを開始します。
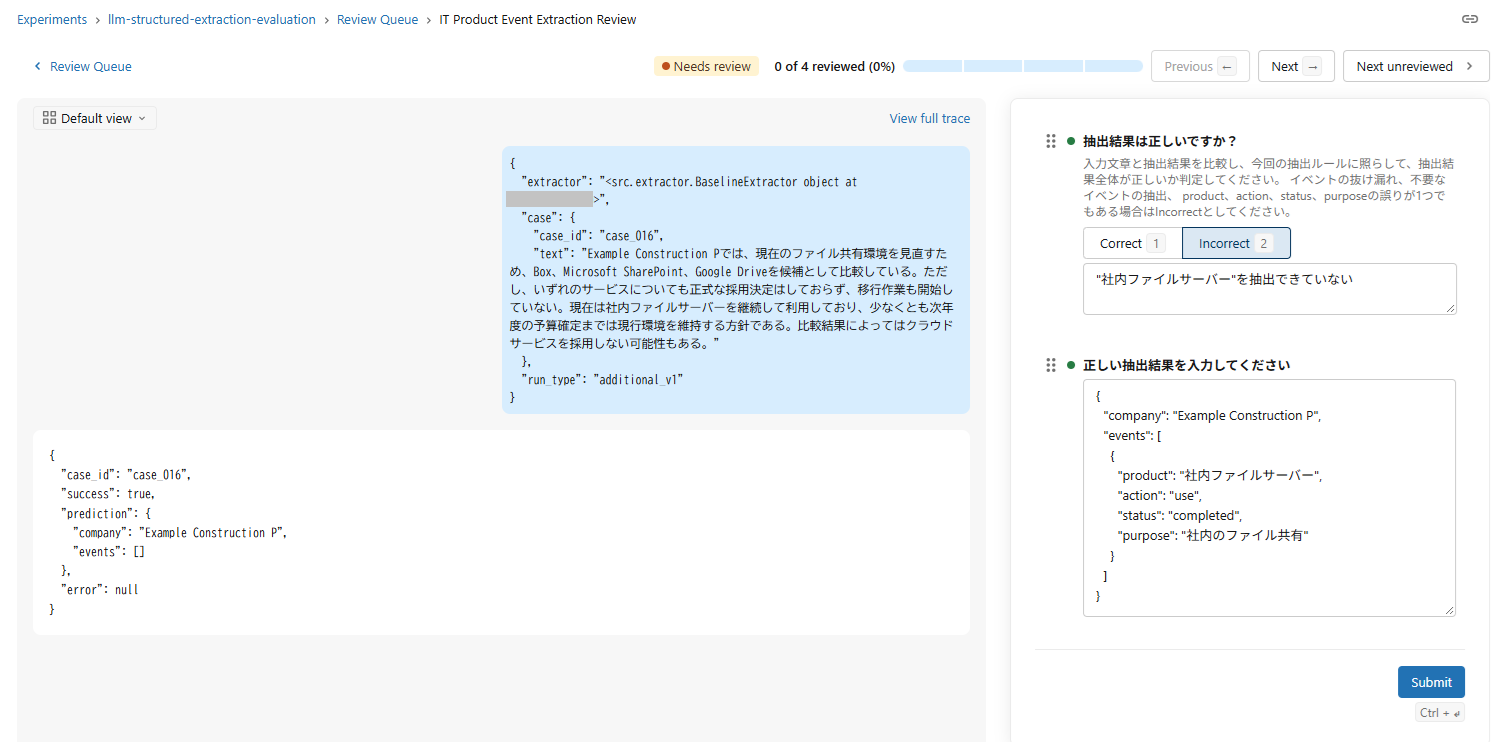
(画像内のデータはサンプルデータで、文章内の企業・事例は架空のものです。)
4件のレビューの結果、以下のようなケースがあることが分かりました。
- 固有の製品名ではなく、一般的な名称(例えば「社内ファイルサーバー」)のシステムの場合、イベントの抽出に失敗する
- 利用目的が文章中で明確に示されていないと、’purpose’がnullになる
- 日本語の文章なのに、‘purpose’を英語で返す
- 同じ’product’に対し、’migrate’と’use’、または’adopt’と’use’が混ざっている
これらの知見は、後のPrompt改善で活かします。
他にも気になるところはありましたが、間違いと言い切れない内容もあり判断が難しいため、今回は上記4つに注目します。
6. Human Reviewを評価用データセットへ反映
前章では、信頼度スコアの低い4件をHuman Reviewの対象とし、正しい抽出結果をExpectationとしてTraceに記録しました。
ここでは、このHuman Reviewで得られた4件のExpectationをGround TruthとしてEvaluation Datasetへ追加します。
これにより、人間によるレビュー結果をその場限りの修正で終わらせず、次回以降の評価に利用できるデータとして蓄積します。
6.1 レビュー済みのTraceからExpectationを取得
まず、Human Reviewを行った4件を対象として、該当するTraceを抽出します。(Traceの取得は4.5とほとんど同じのため割愛します)
REVIEWED_CASE_IDS = { |
"case_014", |
"case_016", |
"case_018", |
"case_020", |
} |
reviewed_traces = traces[ |
traces["tags"].apply( |
lambda tags: tags["case_id"] in REVIEWED_CASE_IDS |
) |
].copy() |
reviewed_traces["case_id"] = ( |
reviewed_traces["tags"].apply( |
lambda tags: tags["case_id"] |
) |
) |
Review Queueで入力したExpectationは、TraceのAssessmentとして保存されています。
そこで、各Traceを’mlflow.get_trace()’で取得し、人間が入力したExpectationを取り出します。
reviewed_records = [] |
for _, row in reviewed_traces.iterrows(): |
case_id = row["case_id"] |
trace_id = row["trace_id"] |
trace = mlflow.get_trace(trace_id=trace_id) |
expectations = [ |
assessment |
for assessment in trace.info.assessments |
if ( |
assessment.source.source_type == "HUMAN" |
and assessment.expectation is not None |
) |
] |
if len(expectations) != 1: |
raise ValueError( |
f"{case_id}: expected exactly one human expectation, got {len(expectations)}" |
) |
expected_response = json.loads( |
expectations[0].expectation.value |
) |
validated = ExtractionResult.model_validate(expected_response) |
request = json.loads(trace.data.request) |
if isinstance(request, str): |
request = json.loads(request) |
reviewed_records.append( |
{ |
"inputs": { |
"text": request["case"]["text"], |
}, |
"expectations": { |
"expected_response": ( |
validated.model_dump(mode="json") |
), |
}, |
"tags": { |
"case_id": case_id, |
}, |
} |
) |
ここではAssessmentのうち、‘source_type’が’HUMAN’、かつ’expectation’が存在するものを取得します。
また、Review Queueでは正しい抽出結果をJSONのテキストとして入力しているため、’json.loads()’でJSONに変換した後、’ExtractionResult.model_validate()’で検証します。
6.2 Human Reviewの結果を評価用データセットへ追加
reviewed_recordsは、すでにEvaluation Datasetへ追加できる形に変換できているため、このまま既存のEvaluation Datasetへ追加します。
dataset = mlflow.genai.datasets.get_dataset( |
name=DATASET_NAME |
) |
dataset.merge_records(reviewed_records) |
これにより、Evaluation Datasetは初期10件から14件になります。
UIからも、4件増えていることを確認することができます。
7. 評価データ拡張後の再評価
前章までで、Human Reviewによって得られたGround Truthを評価用データセットへ反映できました。
本章では、この14件に拡張されたデータセットに対して、再びPrompt v1を実行します。
初期10件だけで評価した時と比べて、評価結果がどのように変化するかを確認します。
7.1 拡張後の評価用データセットで再評価
まずは、拡張後のデータセットに対して、再度Prompt v1で推論を行います。
実行方法は今までとほとんど同じですので割愛します。
評価方法についても4章と同じです。
‘structured_extraction_scorer’を使用して評価した後、’aggregate_summaries()’で結果を集計します。
7.2 評価データ拡張前後の結果を比較
初期10件と、Human Review後の14件で評価した結果は以下のようになりました。
|
指標 |
初期10件 |
拡張後14件 |
|---|
|
Company Accuracy |
1.000 |
1.000 |
|
TP |
11 |
12 |
|
FP |
14 |
20 |
|
FN |
6 |
12 |
|
Precision |
0.440 |
0.375 |
|
Recall |
0.647 |
0.500 |
|
F1 |
0.524 |
0.429 |
|
Matched Events |
14 |
20 |
|
Status Accuracy |
0.857 |
0.700 |
|
Purpose Accuracy |
0.929 |
0.850 |
拡張後のデータセットでは、F1は’0.524’から’0.429’へ低下しました。
TPはほとんど増えていないまま、FP, FNはどちらも大きく増加しています。
また、’status’や’purpose’ のAccuracyも低下しています。
ただし、今回追加した4件は無作為に選んだものではなく、信頼度スコアが低かったケースだということには注意が必要です。
今回の結果は、Human Reviewで見つけた難しいケースを取り込むことで、既存の評価データだけでは見えていなかった課題を評価対象に追加できた、と捉えます。
8. Promptの改善
ここからは、Human Reviewや評価結果から見えた課題を基にPromptを修正し、Prompt v2を作成します。
その後、再度拡張後の評価用データセットで再評価し、Promptの変更が評価結果にどのような影響を与えるかを確認します。
8.1 Promptの改善
Human Reviewや拡張後の評価結果を基に、Prompt v2では次のルールを追加します。
- 固有の製品名だけでなく、一般的な名称のシステム・サービスも抽出する
- ‘purpose’は「~のため」のように明示的でなくても、入力文章から読み取れる場合は抽出する
- ‘purpose’は入力文章と同じ言語で出力する
- 同じproductに対し、migrateとuse、adoptとuseを混ぜない
実際のプロンプトでは、適切な場所に以下のように追記します。
Prompt Registryへの登録は、3.4節と同様に行います。
新しいプロンプトは、バージョン2として保存され、UI上でもバージョンを切り替えて確認することができます。
8.2 Prompt v2で再評価
拡張後の評価用データセットに対して、登録したPrompt v2を用いて同じように推論・評価を行います。
評価結果は以下のようになりました。
|
指標 |
Prompt v1 |
Prompt v2 |
|---|
|
Company Accuracy |
1.000 |
1.000 |
|
TP |
12 |
11 |
|
FP |
20 |
16 |
|
FN |
12 |
13 |
|
Precision |
0.375 |
0.407 |
|
Recall |
0.500 |
0.458 |
|
F1 |
0.429 |
0.431 |
|
Matched Events |
20 |
21 |
|
Status Accuracy |
0.700 |
0.667 |
|
Purpose Accuracy |
0.850 |
0.810 |
Prompt v2では、FPが比較的大きく減少し、結果的にF1はわずかに上昇しました。
一方、’status’や、今回改善したかった’purpose’のAccuracyは減少しています。
つまり、一部に効果があった可能性はありますが、逆効果になった部分もあり、期待した改善につながったとは言えない結果となりました。
※ なお、今回の評価データは14件と少数であり、LLMで生成したサンプルを使用しているため、評価結果は参考値としてご覧ください。
また、Promptの改善に用いたデータを含む評価結果であるため、未知のデータに対する性能向上を示すものではありません。
より厳密に評価する場合は、Promptの改善に使用していない独立した評価データを用意することを推奨します。
今回の結果から確認できるのは、ある課題を修正するためにPromptを変更しても、その変更が別のケースに影響したり、逆効果になったりする可能性があるという点です。
ただし、それは推測で評価するのではなく、定量的に評価することで気付くことができます。
その意味では、今回の結果からも、評価・改善サイクルを設ける意義がうかがえます。
また、運用環境や入力データの変化により、LLMアプリケーションの性能が時間とともに低下する可能性もあります。
そのため、評価と改善のサイクルを常に回し、監視できるようにすることが、信頼性のあるLLMアプリケーションを構築するために重要です。
9. まとめ
本記事では、Databricks Data + AI Summit 2026のセッション「Stop Guessing, Start Scoring: LLM Extraction Evaluation on Databricks」で紹介されていた考え方を参考に、DatabricksとMLflowを利用して、LLMによる構造化データ抽出の評価・改善サイクルを実装しました。
本記事では、次のような学びがありました。
- 構造化抽出はJSON全体一致ではなく、イベント対応付け+フィールド別評価で見ると改善点が分かりやすい。
- Human Reviewはその場の修正で終わらせず、ExpectationとしてEvaluation Datasetへ戻すことで継続評価に活用できる。
- 信頼度スコアを活用することで、重点的にチェックすべきケースを効率よく探すことができる。
- 一部の指標を改善するために行った修正が、他指標を悪化させることもあるため、定量評価を回し続けることが重要である。
今回実装した、
データ抽出 → Human Review → フィードバックの収集 → 評価 → 改善
というサイクルは、多くのLLMアプリケーションに応用できる考え方だと思います。
本記事が、LLMアプリケーションを継続的な改善につなげる仕組みを考える際の参考になれば幸いです。
参考文献
Stop Guessing, Start Scoring: LLM Extraction Evaluation on Databricks